はじめに
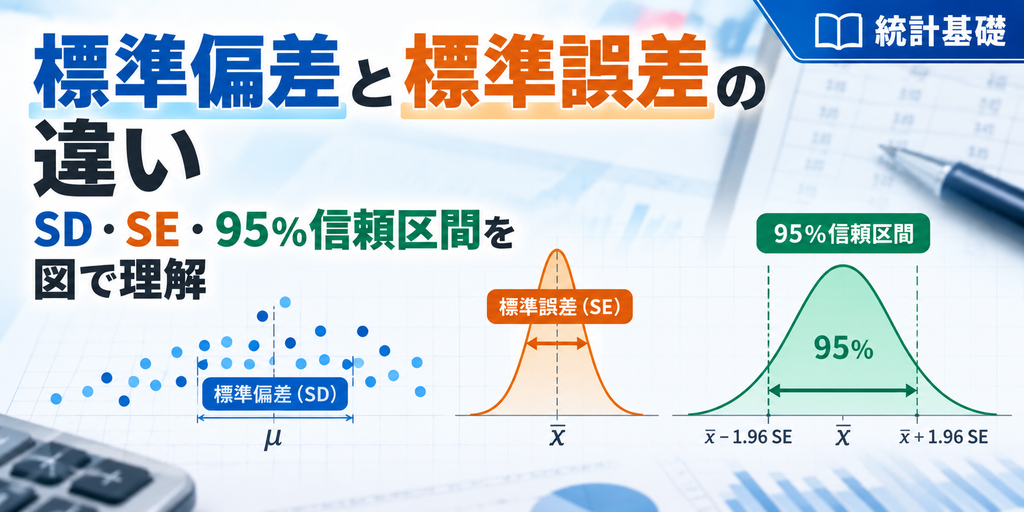
論文や実験結果、品質データのグラフで、「平均±SD」「平均±SE」「平均と95%信頼区間」という表記を見たことはありませんか。どれも平均値の周辺に表示されるため、「全部、データのばらつきを表しているのでは?」と混同しやすい指標です。
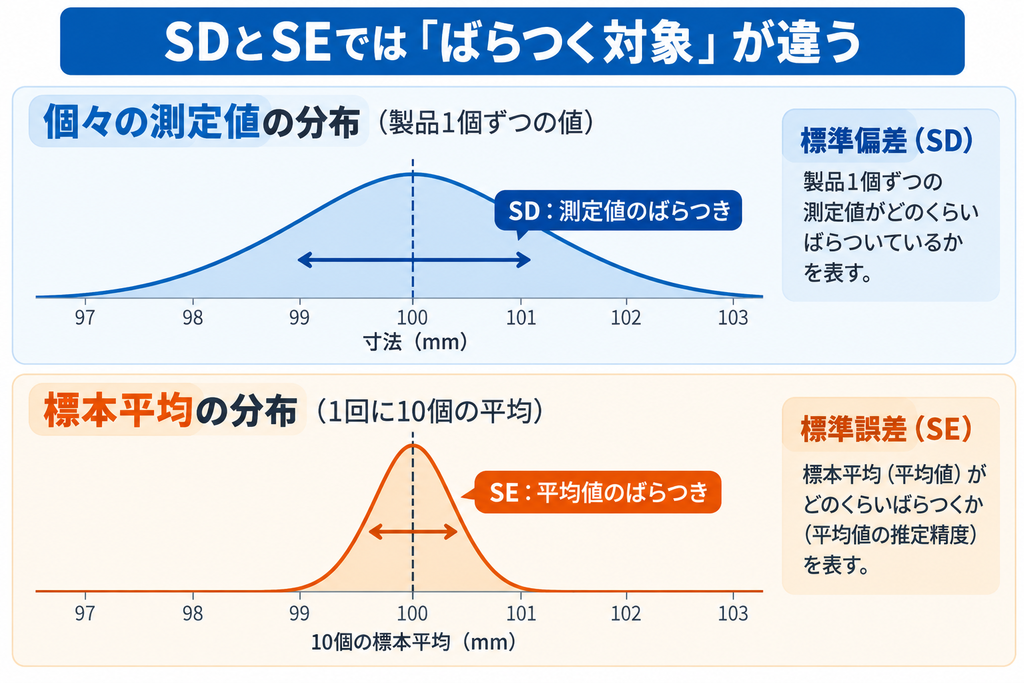
SDとSEでは、そもそも表している「ばらつき」が違います。SDは個々の測定値のばらつき、SEは標本平均のばらつきを表します。95%信頼区間は、そのSEを使って母平均の推定の不確かさを範囲で示したものです。
この記事では、製品寸法の10個のデータを使って、平均、SD、SE、95%信頼区間を順に計算します。さらに、サンプル数を変えた図から、3つの指標の使い分けを確認しましょう。
・SEは、標本平均のばらつき・平均値の推定精度を表します。
・平均のSEは、標本SDを使うと「SD ÷ √n」で推定できます。
・95%信頼区間は、平均を中心に「t値 × SE」の幅を取ります。
・エラーバーでは、SD・SE・95%CIのどれを表示したか明記することが重要です。
標準偏差と標準誤差の違いを先に整理
まず「何についてのばらつきか」を分けて考えます。ここで母平均とは、調べたい工程全体の真の平均値のことです。
SDはデータを見る指標、SEと95%CIは平均値の推定を見る指標です。サンプル数が増えてSEが小さくなっても、製品1個ずつの寸法のばらつきが減ったとは限りません。
標準偏差(SD)とは?
標準偏差(Standard Deviation:SD)は、それぞれの測定値が平均からどの程度離れているかを表します。同じ平均寸法でも、100 mm付近に集まる工程と、98~102 mmに広がる工程では、SDが異なります。
本記事では、標本標準偏差sを使います。標本とは、工程全体から取り出して測定した一部のデータです。
sは標本標準偏差、xiは各データ、x̄は標本平均、nはサンプル数です。Σは「すべて足し合わせる」という記号です。データから平均も推定するため、標本分散ではn−1で割ります。
SDは測定値と同じ単位で表せます。寸法のデータならSDの単位もmmなので、製品のばらつきを実際の大きさとして捉えられます。
標準誤差(SE)とは?
同じ工程から10個ずつサンプリングして平均を求めても、毎回まったく同じ値にはなりません。例えば、1回目は100.1 mm、2回目は99.8 mm、3回目は100.0 mmというように、平均値そのものも変動します。これらは考え方を示す例です。
この標本平均のばらつきの大きさを表すのが、平均の標準誤差(Standard Error:SE)です。SEが小さいほど、同じ条件で平均を取り直したときの変動が小さく、母平均を精度よく推定できていると考えます。
これは、同じ母集団から独立に得られたデータについての式です。厳密には、母標準偏差σが分かる場合の平均のSEはσ/√nです。通常はσが分からないので、標本SDのsを使って推定します。なお、標準誤差は平均以外の推定値にも使う概念ですが、本記事では平均のSEに絞ります。
! SEが小さいことと、工程のばらつきが小さいことは別
SEが小さくなった理由がサンプル数 n の増加であれば、 製品1個ずつのばらつきそのものが改善したわけではありません。 工程のばらつきを評価したい場合は、SEだけでなくSDやデータの分布も確認 しましょう。
SDとSEの違いを表で比較
グラフを読んだり結果を報告したりするときは、次の問いで使い分けると整理できます。
| 知りたいこと | 主に見る指標 | その指標だけでは分からないこと |
|---|---|---|
| 製品1個ずつの寸法は、どれくらいばらつく? | SD | 平均値の推定精度 |
| 今回の平均は、どれくらい精度よく推定できた? | SE | 製品1個ずつのばらつきの大きさ |
| 母平均の推定の不確かさを範囲で示したい | 95%CI | 個々の製品の95%が入る範囲 |
サンプル数が増えるとSEはどう変わる?
SE=s/√nなので、SDを固定すると、サンプル数nが増えるほど分母が大きくなり、SEは小さくなります。例えば、nを4倍にすると√nは2倍になり、SEは半分になります。
一方、SDは工程そのもののばらつきを推定する指標です。同じ工程から測定数を増やすことは、工程改善とは異なります。実際の標本SDはサンプリングによって上下しますが、nを増やせば必ず小さくなるという関係はありません。
製造業のデータでSD・SE・95%信頼区間を計算してみる
ある工程で製造した部品の寸法を10個測定したとします。説明用のデータとして、次の値を使います。単位はmmです。
| No. | 寸法(mm) |
|---|---|
| 1 | 98 |
| 2 | 99 |
| 3 | 99 |
| 4 | 100 |
| 5 | 100 |
| 6 | 100 |
| 7 | 100 |
| 8 | 101 |
| 9 | 101 |
| 10 | 102 |
まずデータの中心を平均で表し、次に個々の値のばらつきをSDで求めます。そのSDから平均のSEを推定し、最後に母平均の95%信頼区間を計算します。独立に採取したデータで、母集団の分布を正規分布と仮定した例です。
計算では丸める前の値を使い、SD・SE・区間の端点などは小数第3位まで表示します。電卓で表示値を使うと、最後の桁がわずかに変わることがあります。
STEP 1:平均を求める
平均は、データの合計をサンプル数で割って求めます。後で各値が平均からどれだけ離れているかを計算するため、最初に中心を確認します。
+ 100 + 100 + 101 + 101 + 102 = 1000
今回の10個のデータは、100.0 mmを中心にばらついています。平均だけでは、そのばらつきの大きさまでは分かりません。
STEP 2:標準偏差を求める
各データから平均100.0を引きます。その差を2乗すると、正負の差が打ち消し合わず、平均からの離れ方を集計できます。
| xi(mm) | xi−x̄(mm) | (xi−x̄)2(mm²) |
|---|---|---|
| 98 | -2 | 4 |
| 99 | -1 | 1 |
| 99 | -1 | 1 |
| 100 | 0 | 0 |
| 100 | 0 | 0 |
| 100 | 0 | 0 |
| 100 | 0 | 0 |
| 101 | +1 | 1 |
| 101 | +1 | 1 |
| 102 | +2 | 4 |
= 4 + 1 + 1 + 0 + 0 + 0 + 0 + 1 + 1 + 4
= 12 mm²
次にn−1=9で割り、標本分散s²を求めます。分散の単位はmm²です。平方根を取ると、元の寸法と同じmmの単位に戻ります。
= 12 / 9 ≈ 1.333 mm²
≈ 1.155 mm
このSDは、部品1個ずつの寸法が100.0 mmの周囲にどれくらいばらついているかを表します。平均の推定精度を表している値ではありません。
STEP 3:標準誤差を求める
平均の推定精度を見るため、SDを√nで割ります。今回はn=10なので、√10≈3.162です。
≈ 1.155 / √10
≈ 1.155 / 3.162
≈ 0.365 mm
SD=約1.155 mmに対し、SE=約0.365 mmとなりました。SDは個々の寸法、SEは10個から求める平均の変動を見ています。数字の大小だけを比べて、工程のばらつきが小さくなったと解釈しないでください。
STEP 4:95%信頼区間を求める
SEを使うと、母平均の推定の不確かさを区間で示せます。母標準偏差が未知で、正規分布の母集団から独立に得た標本については、t分布を使います。t分布は、少ないデータからばらつきも推定する不確かさを考慮した分布です。
自由度はdf=n−1=9です。自由度は、ここではt分布の形を決める数と考えてください。両側95%では、区間の外側に残る5%を左右2.5%ずつに分けるため、t分布の累積確率0.975の値を使います。
t0.975, 9 ≈ 2.262
このt値はt分布表から確認できます。ExcelならT.INV.2T(0.05,9)、PythonのSciPyならstats.t.ppf(0.975,9)で求められ、丸める前は2.262157…です。すべてのサンプル数で1.96を使うわけではありません。
≈ 100.0 ± 0.826 mm
上限 = 100.0 + 0.826 = 100.826 mm
平均±SEは、95%信頼区間ではありません。今回の95%CIでは、SEの約2.262倍を平均の両側に取っています。
| 指標 | 今回の結果 | 何を見ている? |
|---|---|---|
| 平均 | 100.0 mm | 今回測定した10個の中心 |
| SD | 1.155 mm | 個々の寸法のばらつき |
| SE | 0.365 mm | 平均値の推定精度 |
| 母平均の95%CI | 99.174~100.826 mm | 母平均の推定の不確かさ |
この結果は「製品の95%が99.174~100.826 mmに入る」という意味ではありません。CIが対象にしているのは、個々の製品ではなく工程の母平均です。製品の適合性は規格・公差や工程のばらつきも含めて評価します。
サンプル数を変えるとSD・SE・95%信頼区間はどう変わる?
サンプル数だけの影響を見るため、標本平均=100.0 mm、標本SD=√(12/9)≈1.155 mmという同じ値に固定して、n=5、10、20、100を比較します。これは同じ工程・ばらつき条件を想定した概念比較であり、各nについて新たな実データを測定した結果ではありません。
母標準偏差は未知として扱い、どの行もt分布で平均の95%CIを計算します。実際に採り直した標本では平均もSDも変動するため、常にこの表のように同じ値になるわけではありません。
| n | SD(mm) | SE(mm) | t値 df=n−1 | 母平均の95%CI(mm) |
|---|---|---|---|---|
| 5 | 1.155 | 0.516 | 2.776 | 98.566~101.434 |
| 10 | 1.155 | 0.365 | 2.262 | 99.174~100.826 |
| 20 | 1.155 | 0.258 | 2.093 | 99.460~100.540 |
| 100 | 1.155 | 0.115 | 1.984 | 99.771~100.229 |
例えばn=5では、SE=√(12/9)/√5≈0.516 mmです。自由度4のt値は約2.776なので、区間の半幅は約1.434 mmになります。n=100では、SE≈0.115 mm、自由度99のt値は約1.984、半幅は約0.229 mmです。
この比較ではSDは一定ですが、nが増えるほどSEが小さくなります。加えてt値も小さくなり、95%CIは狭くなっています。平均の推定精度を上げる方法の一つが、独立したサンプルを増やすことです。
エラーバーではSD・SE・95%信頼区間のどれを使う?
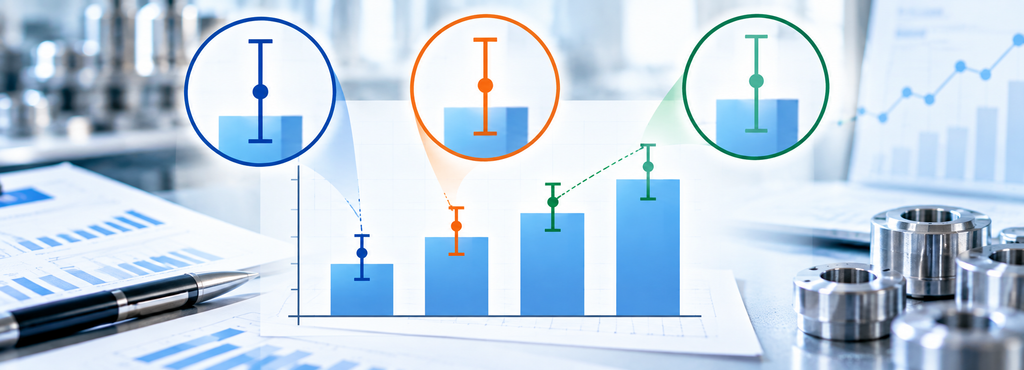
エラーバーは、グラフ上で値の周囲に付ける線です。何を伝えたいかによって、表示する指標を選びます。
・SD:測定データそのもののばらつきを見せたい場合。
・SE:平均値の推定精度を見せたい場合。
・95%CI:母平均の推定範囲・不確かさを示したい場合。
エラーバーは、SD・SE・95%CIのどれを使ったかによって意味が全く異なります。図の注記には「平均±SD」「平均±SE」「平均と95%CI」とサンプル数を明記しましょう。
また、エラーバーの重なりだけで、2群に有意差があるかを判断しないでください。差を評価したい場合は、対応の有無などに合わせた検定や、平均値差の信頼区間を確認します。
エラーバーの詳しい見方・使い分けについては、別記事で詳しく解説します。
SD・SE・95%信頼区間を使うときの注意点
SDとSEを混同しない
SEがSDより小さくても、データそのもののばらつきが減ったことにはなりません。報告書には指標名を明記し、工程ばらつきの評価にはSDや分布も使います。
サンプル数と独立性を確認する
SEはサンプル数の影響を受けます。同じ製品を何度も測った値や、連続して強く相関するデータを、すべて独立した製品のデータとして数えると、s/√nで推定したSEが小さすぎることがあります。10個の値をコピーして20個にしても、新たな独立サンプルを増やしたことにはなりません。
SEと95%CIを同じものとして扱わない
95%CIにはSEに加えて、信頼水準と自由度に応じたt値が必要です。SDを同じ値に固定しても、nが変わればSEとt値の両方が変わります。
95%CIは母平均の区間であり、個々の製品の範囲ではない
95%CIの95%は、同じ方法でサンプリングと区間計算を繰り返したとき、長期的に約95%の区間が母平均を含むという意味です。今回計算した固定の区間に、母平均が95%の確率で存在すると断定する説明は避けます。詳しくは前掲の信頼区間の記事を参照してください。
小標本では分布と測定条件にも注意する
今回のt分布による区間は、正規分布の母集団から独立に得られた標本を前提としています。n=10程度で強い歪みや外れ値がある場合は、機械的に同じ式を適用せず、分布と採取方法を確認します。SEやCIだけでは、測定器の偏りやサンプリングの偏りも評価できません。
Stat Lab Analyticsで確認する
手計算の考え方を理解したら、実際のデータでも確認してみましょう。Stat Lab Analytics(StatLA)の「基本統計量」や「信頼区間」から、平均・標準偏差・標準誤差・母平均の95%信頼区間を確認できます。
今回の10個の寸法データを入力すれば、本文の結果と比較できます。標準偏差の計算方法や信頼水準を確認し、表示の桁数が異なる場合は丸め前の値も意識してください。操作手順は、基本統計量の操作記事と信頼区間の操作記事で確認できます。
無料統計ソフト Stat Lab Analytics
Excelで理解したら、 実際のデータでも解析してみよう。
StatLAなら、データを入力して解析するだけで 平均・標準偏差・信頼区間などを ブラウザ上で確認できます。 Excelで計算方法を理解した後の実践にもおすすめです。
- 無料
- 登録不要
- インストール不要
まとめ
標準偏差(SD)と標準誤差(SE)は似た名称ですが、評価している対象は異なります。SDは個々の測定値のばらつき、SEは標本平均のばらつきです。95%CIは、そのSEを使って母平均の推定の不確かさを区間で表します。
今回の寸法データでは、平均100.0 mm、SD約1.155 mm、SE約0.365 mm、母平均の95%CIは99.174~100.826 mmでした。元データから平均、SD、SE、CIへ順に進めると、それぞれが何を表すかを区別しやすくなります。
✅SDは、個々のデータのばらつきを表します。
✅平均のSEは、標本SDを使うとSD/√nで推定できます。
✅同じSDなら、サンプル数が増えるほどSEは小さくなります。
✅母標準偏差が未知の正規母集団では、母平均の95%CIを平均±t値×SEで求めます。
・エラーバーには、SD・SE・95%CIのどれかとサンプル数を明示します。
まずは「何のばらつきを表しているのか」を意識すると、SD・SE・95%信頼区間を混同しにくくなります。工程のばらつきを伝えるのか、平均の推定精度を伝えるのかを決めてから、指標を選びましょう。
計算式の参考:NIST/SEMATECH e-Handbook「Confidence Limits for the Mean」。t値はSciPyのt分布の分位点から計算し、表と図には同じ丸め前の値を使っています。
「研究・品質改善で統計解析方法に迷っている」
製造業・医療機器分野で統計解析を実践してきた専門家が、
目的に合わせた解析方法の選定から結果解釈までサポートします。