3つ以上の独立したグループを比較したいものの、データが正規分布とは考えにくい。外れ値の影響が気になり、実測値の大小関係を中心に評価したい。このような場面で候補になるのが、Kruskal–Wallis検定です。
本記事では、Kruskal–Wallis検定を使う場面、順位を使った計算方法、検定統計量Hとp値の読み方を、3つの加工方法のサイクルタイムを比較する事例で順番に解説します。
・Kruskal–Wallis検定は、独立した3群以上を順位で比較するノンパラメトリック検定です。
・一元配置分散分析の前提を置きにくい場合や、順序尺度のデータを扱う場合に候補になります。
・全群のデータをまとめて順位付けし、群ごとの順位和の違いを検定統計量Hで評価します。
・p値が小さくても、どの群とどの群が異なるかまでは分かりません。
・有意となった後は、多重比較と実務上の差の大きさを確認します。
Kruskal–Wallis検定とは?
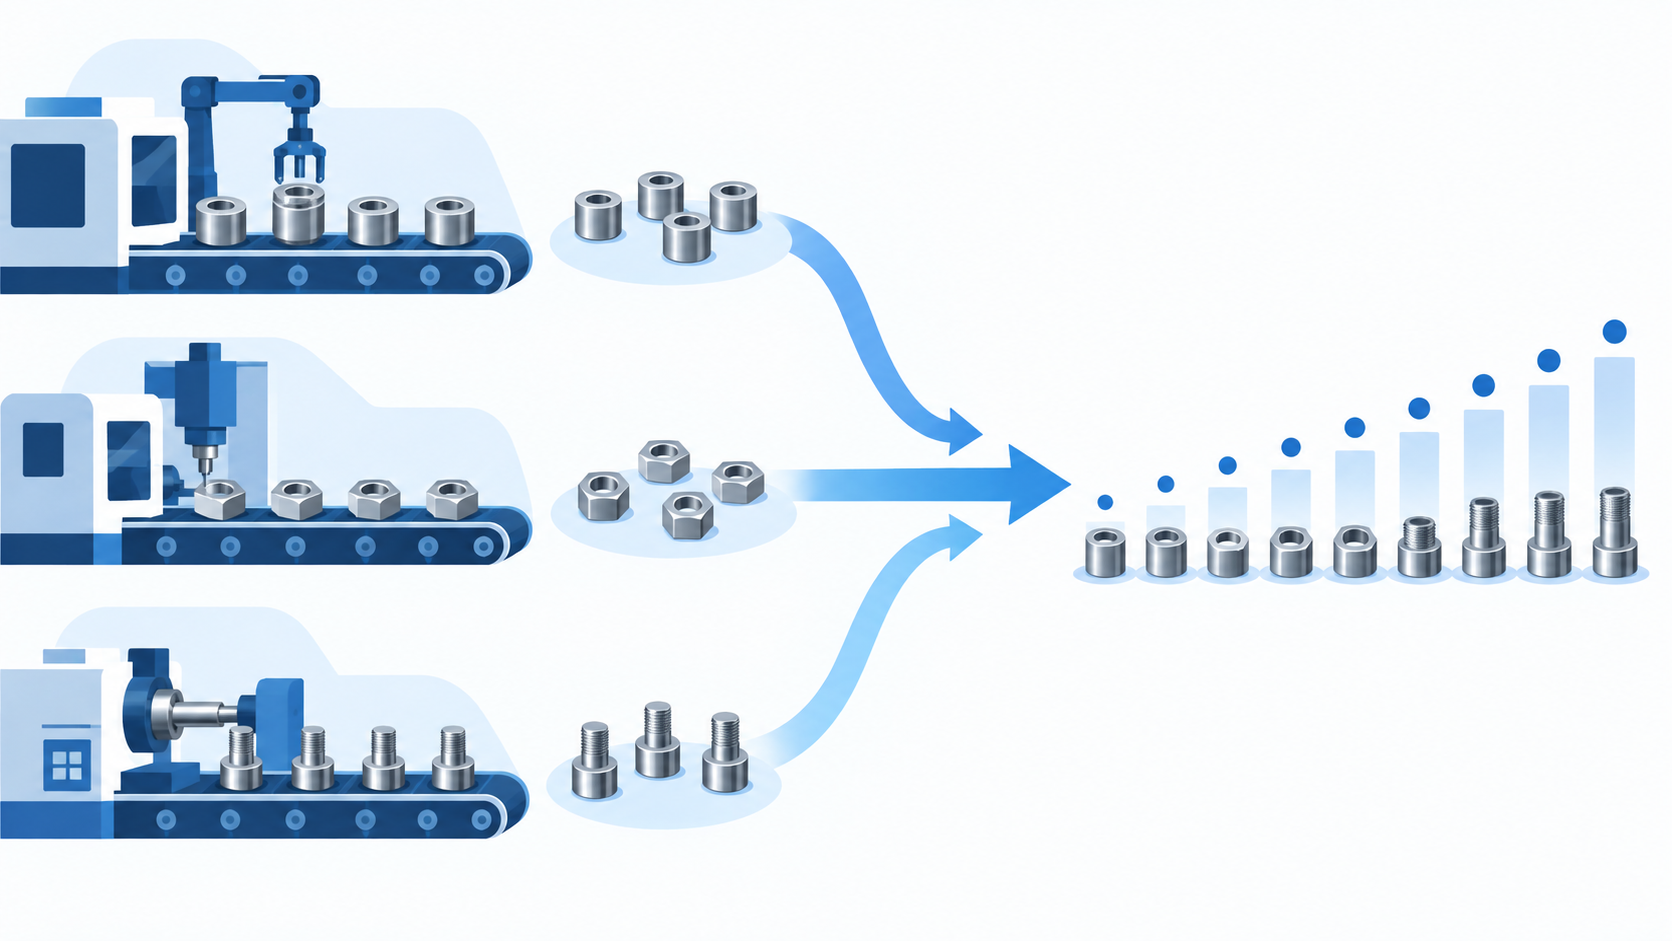
Kruskal–Wallis検定(クラスカル・ウォリス検定)は、独立した3群以上の分布を順位に基づいて比較するノンパラメトリック検定です。独立2群に用いるMann–Whitneyの順位和検定を、3群以上へ拡張した方法と考えると理解しやすくなります。
一元配置分散分析は、群間の平均値の違いを実測値と分散から評価します。一方、Kruskal–Wallis検定では、すべての測定値を小さい順に並べて順位へ変換し、群ごとの順位の偏りを評価します。
| 確認項目 | 一元配置分散分析 | Kruskal–Wallis検定 |
|---|---|---|
| 対象 | 独立した3群以上 | 独立した3群以上 |
| 主に使う情報 | 実測値と群内・群間の変動 | 全データを統合した順位 |
| 主な分布の考え方 | 各群の誤差が概ね正規分布 | 少なくとも順序付けできる |
| 代表的な問い | 母平均がすべて等しいか | 各群の分布が同じか |
Kruskal–Wallis検定を単純な「中央値の検定」と説明することがありますが、厳密には各群の分布全体を順位で比較します。各群の分布形状やばらつきが概ね同じで、位置だけが異なると考えられる場合に、中央値などの位置の違いとして解釈しやすくなります。
どんな場面で使う?
Kruskal–Wallis検定は、異なる設備、材料、加工方法、仕入先などから得た3群以上のデータを比較し、それぞれの観測値が互いに独立している場合に使用します。
製造業では、3種類の加工条件でサイクルタイムを比較する、3社の材料で強度を比較する、複数設備で表面粗さを比較するといった場面が代表例です。正規分布を仮定しにくい連続データだけでなく、少なくとも大小関係を付けられる順序尺度のデータにも利用できます。
対応のある3群には使わない
同じ製品を3条件で繰り返し測定したデータなど、観測値に対応関係がある場合は、Kruskal–Wallis検定ではなくFriedman検定などを検討します。解析前に、対応あり・対応なしデータの違いを確認してください。
各群の平均値を比較する一元配置分散分析との違いを確認したい方は、一元配置分散分析の解説もご覧ください。正規性だけで機械的に手法を決めず、測定尺度、外れ値、分布形状、サンプルサイズ、解析目的を合わせて判断します。
数理的な考え方
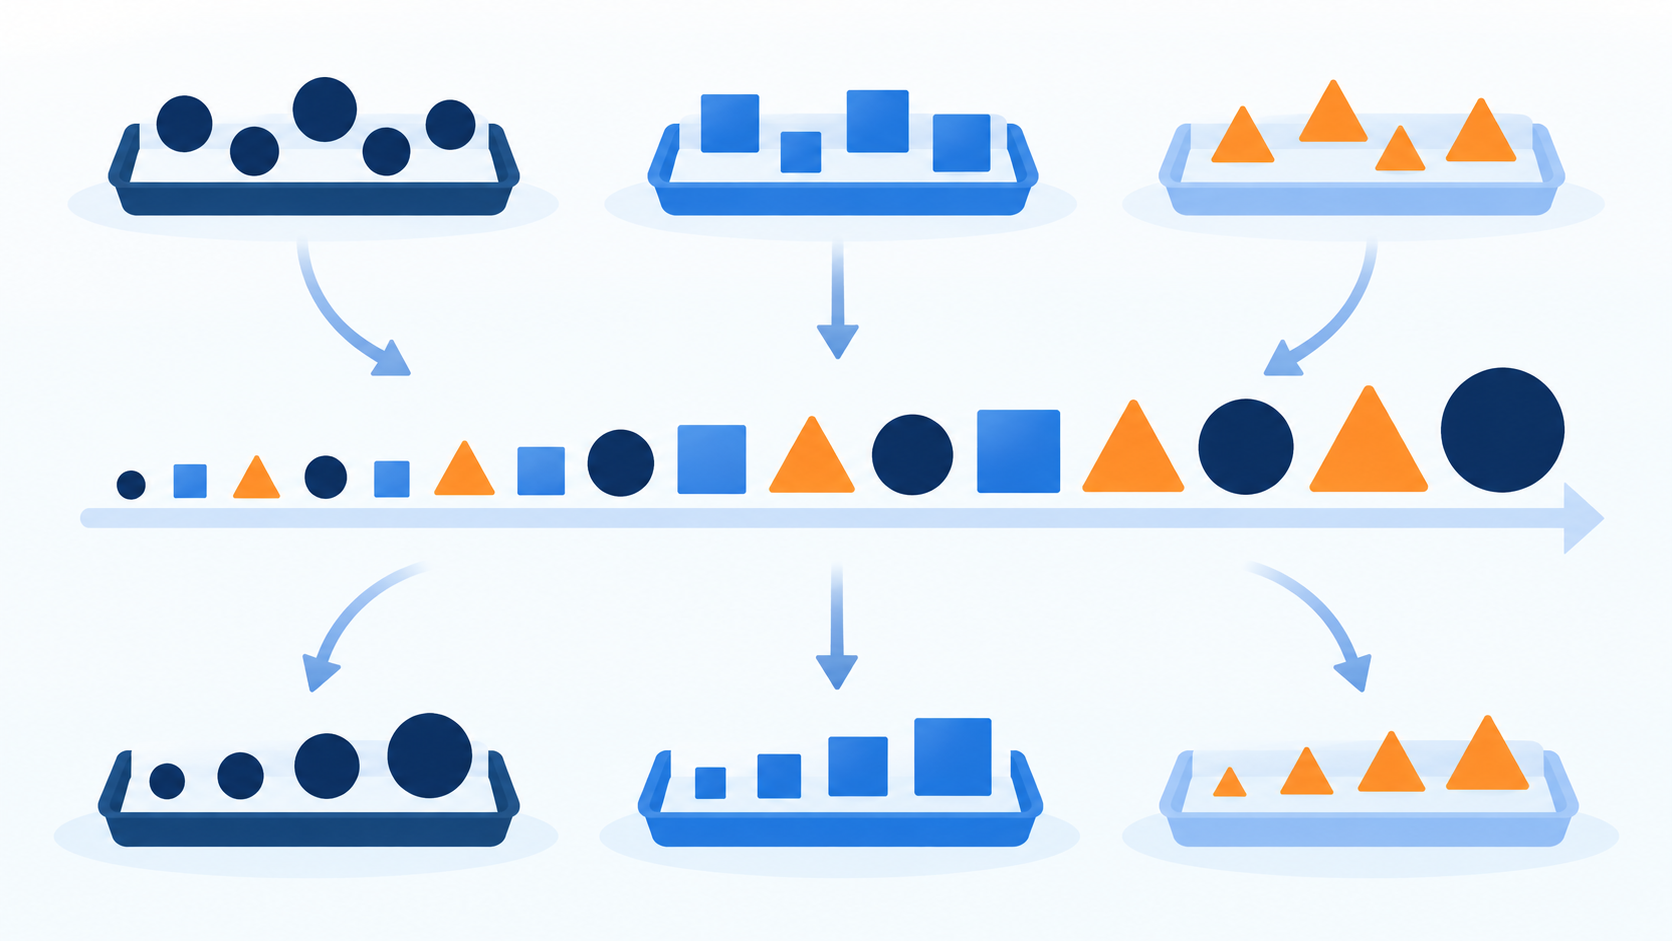
最初に、すべての群の測定値を一つにまとめ、小さい値から順に1、2、3、…と順位を付けます。同じ値がある場合は、その順位の平均を割り当てます。その後、群ごとに順位を戻して順位和Rjを求めます。
・N:全群を合わせたサンプルサイズ
・nj:群jのサンプルサイズ
・Rj:群jの順位和
・k:比較する群の数
各群の順位がよく混ざっていれば、群ごとの平均順位は近くなり、Hは小さくなります。特定の群に小さい順位または大きい順位が偏るほど、Hは大きくなります。
一般的には、帰無仮説のもとでHが自由度k−1のカイ二乗分布に近似するとしてp値を求めます。サンプルサイズが小さい場合は近似精度に注意し、ソフトウェアによっては正確確率法や置換法も検討します。
同じ値がある場合は、次の係数でHを補正します。今回の事例には同順位がないため、補正は不要です。
事例:3つの加工方法でサイクルタイムを比較する
独立した3つの加工方法A・B・Cについて、それぞれ5回のサイクルタイム(秒)を測定しました。解析目的は、3つの加工方法でサイクルタイムの分布に違いがあるかを確認することです。
帰無仮説H0:3つの加工方法の母集団分布は同じである
対立仮説H1:少なくとも1つの加工方法の母集団分布が異なる
有意水準:α=0.05
STEP1 全測定値をまとめて順位を付ける
| 加工方法 | サイクルタイム(秒) | 全15件中の順位 |
|---|---|---|
| A | 45.1 | 9 |
| A | 44.8 | 6 |
| A | 45.0 | 8 |
| A | 44.9 | 7 |
| A | 45.2 | 10 |
| B | 46.0 | 14 |
| B | 45.7 | 11 |
| B | 45.9 | 13 |
| B | 45.8 | 12 |
| B | 46.1 | 15 |
| C | 44.3 | 3 |
| C | 44.5 | 5 |
| C | 44.4 | 4 |
| C | 44.2 | 2 |
| C | 44.1 | 1 |
全15件を小さい順に並べると、加工方法Cが順位1〜5、Aが順位6〜10、Bが順位11〜15を占めます。今回は同じ測定値がないため、平均順位を割り当てる処理はありません。
STEP2 群ごとの順位和を求める
| 加工方法 | nj | 順位和Rj | 平均順位 | 中央値(秒) |
|---|---|---|---|---|
| A | 5 | 40 | 8.0 | 45.0 |
| B | 5 | 65 | 13.0 | 45.9 |
| C | 5 | 15 | 3.0 | 44.3 |
順位和は、Aが9+6+8+7+10=40、Bが14+11+13+12+15=65、Cが3+5+4+2+1=15です。確認として、40+65+15=120となり、1から15までの順位合計15×16÷2=120と一致します。
STEP3 検定統計量Hを計算する
比較する群は3つなので、自由度はdf=3−1=2です。
STEP4 カイ二乗分布からp値を求める
p=0.001930は有意水準0.05より小さいため、帰無仮説を棄却し、3つの加工方法の分布には統計的に有意な違いが認められたと判断します。
ただし、p値は「3群が同じである確率」や「観測結果が偶然である確率」ではありません。帰無仮説が正しいと仮定した場合に、今回のH=12.5以上に極端な順位の偏りが得られる確率です。
また、この検定結果だけでは、A・B・Cのどの組み合わせが異なるかは分かりません。中央値はBが最も大きくCが最も小さいため実務上の候補は見えますが、特定の組み合わせを統計的に判断するには事後比較が必要です。
使用するときの注意点
- ✅ 観測値の独立性を確認する
観測値同士に対応・依存がないことが前提です。同じ対象を3条件で繰り返し測定した場合は、Friedman検定などを検討します。
- ✅ 「中央値だけの検定」と解釈しない
分布形状やばらつきが大きく異なると、有意差が位置の違いだけによるとは限りません。箱ひげ図やヒストグラムも確認しましょう。
- ✅ 有意差のある組み合わせは事後比較で確認する
全体の検定だけでは、どの群が異なるかは分かりません。Dunn法などの事後比較にHolm法・Bonferroni法などの多重性調整を用い、無調整の2群検定の繰り返しは避けます。
- ✅ 同順位の補正を確認する
同じ測定値がある場合は、検定統計量Hの同順位補正が必要です。手計算やソフト間比較では、設定と出力を確認してください。
- ✅ 少数データでは近似精度に注意する
各群の件数が少ないと、カイ二乗近似が十分でない場合があります。正確確率法・置換法や追加データの取得を検討します。
- ✅ p値と実務上の重要性を分けて評価する
中央値・四分位範囲・分布形状・差の大きさも確認し、製造条件や規格に照らして判断します。
まとめ
Kruskal–Wallis検定は、独立した3群以上を順位に基づいて比較するノンパラメトリック検定です。すべての測定値をまとめて順位付けし、群ごとの順位和の偏りを検定統計量Hで評価します。
使用時には、群同士の独立性、測定尺度、分布形状、同順位、サンプルサイズを確認します。「正規分布でないから使う」と機械的に決めるのではなく、一元配置分散分析を含む候補からデータ構造と解析目的に合う方法を選ぶことが重要です。
検定が有意でも、どの群が異なるかまでは分かりません。分布図と代表値を確認したうえで、多重性を調整した事後比較を行い、統計的な差と実務上重要な差を分けて判断してください。
統計手法の選択や解析結果の解釈についてご相談をご希望の方は、記事サイドバーの「統計解析のご相談受付中」よりお問い合わせください。
Stat Lab Analytics(StatLA)
統計を理解したら、実際のデータで試してみよう。
ブラウザだけで統計解析。
登録不要・無料で利用できます。
- 登録不要
- 無料
- ブラウザで利用可能