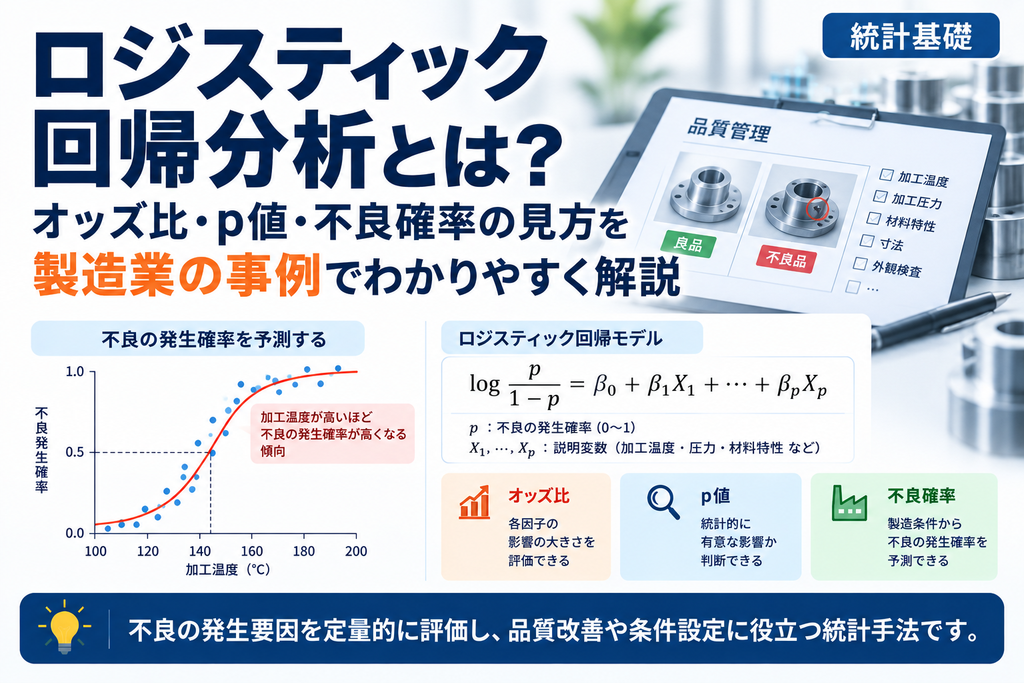
製造現場では、製品強度や寸法のような連続値だけでなく、「良品か不良品か」「合格か不合格か」といった2つの結果を扱うことがあります。このような0/1データと加工条件の関係を分析するときに使うのが、ロジスティック回帰分析です。
この記事では、加工温度と不良発生の架空データを使い、ロジット、最尤法、オッズ比、p値、予測不良確率を順に計算します。最後に要因効果プロットを確認し、解析結果を製造現場でどう解釈するかまで解説します。
ロジスティック回帰分析は、良品/不良品など0/1の二値データを目的変数とする分析方法です。
説明変数から、不良などのイベントが発生する確率を推定できます。
回帰係数をexp変換したオッズ比から、説明変数がイベント発生に与える影響を評価できます。
要因効果プロットのシグモイド曲線から、説明変数に伴う発生確率の変化を確認できます。
ロジスティック回帰分析とは?
ロジスティック回帰分析は、良品/不良品のような2つの結果について、説明変数との関係を分析する方法です。加工温度が高くなるほど不良になりやすいか、さらに不良確率がどのように変化するかを推定できます。
加工圧力と故障の有無、材料特性と合否などにも利用できます。「回帰」という名前ですが、予測するのは強度や寸法そのものではなく、イベントが発生する確率です。
ロジスティック回帰分析はどんなデータに使う?
ロジスティック回帰分析で扱う目的変数Yは、0か1で表される二値データです。例えば、良品を0、不良品を1とすれば、モデルが推定するpは不良が発生する確率になります。
故障なし=0・故障あり=1、合格=0・不合格=1のような定義も可能です。どちらを1にするかで係数とグラフの解釈方向が変わるため、解析前にイベントの定義を明確にします。
説明変数Xには、加工温度、加工時間、圧力、材料特性などの連続変数を使えます。設備A/Bや材料種類のようなカテゴリ変数も、ダミー変数などで適切に符号化すればモデルへ組み込めます。
ロジスティック回帰分析はどんなときに使う?
製造業では、「加工温度が高くなるほど不良が発生しやすくなるか」「加工時間が長いほど故障確率が高くなるか」といった問いに使います。単に不良を分類するだけでなく、説明変数が変化したときにイベント発生確率がどう変化するかを評価できる点が重要です。
結果から、工程条件が不良発生と関係する方向や大きさを確認できます。ただし、予測確率だけで工程条件を決めず、品質要求、製造余裕、コスト、実験計画も合わせて判断します。
線形回帰分析とロジスティック回帰分析の違い
| 項目 | 線形回帰分析 | ロジスティック回帰分析 |
|---|---|---|
| 目的変数 | 連続値 | 0/1の二値データ |
| 予測するもの | 強度・寸法などの値 | イベントの発生確率 |
| モデル | Y=β0+β1X | logit(p)=β0+β1X |
| 予測値の範囲 | −∞~∞ | 0~1 |
| 製造業の例 | 温度から強度を予測 | 温度から不良確率を予測 |
0/1をそのまま線形回帰すると、予測値が−0.2や1.3のように、確率としてあり得ない範囲になる場合があります。ロジスティック回帰では、予測確率が必ず0~1の範囲になるようにモデル化します。
そのため、説明変数と予測確率の関係は直線ではなく、両端が0と1へ近づくS字型のシグモイド曲線になります。
ロジスティック回帰分析の考え方
pを製品が不良になる確率とします。確率を直接直線で表す代わりに、確率からオッズ、さらに対数オッズであるロジットへ変換します。
ロジットは−∞から∞までの値を取れるため、説明変数Xの線形式で表せます。回帰式から実際の不良確率へ戻すときは、次のロジスティック関数を使います。
0 < p < 1
どのようなXを代入してもpは0と1の間に収まります。これが、ロジスティック回帰の予測値がS字型になる理由です。
オッズとオッズ比とは?
オッズは発生と非発生の比
オッズは、イベントが発生する確率と発生しない確率の比です。不良確率が20%ならp=0.20、不良にならない確率は0.80なので、オッズは0.25です。
= 0.20 ÷ 0.80
= 0.25
オッズ比はXが増えたときのオッズの倍率
回帰係数β1を指数変換したexp(β1)が、Xが1単位増えたときのオッズ比です。例えばβ1=0.405なら、オッズ比は約1.50になります。
= exp(0.405)
≒ 1.50
POINT:オッズ比と確率は同じではありません
オッズ比1.5は、不良確率が1.5倍になるという意味ではありません。正しくは「不良発生のオッズが1.5倍になる」です。確率の変化量は、変化前の確率によって異なります。
| オッズ比 | 意味 | 不良=1の場合 |
|---|---|---|
| OR=1 | Xが変化してもオッズは変わらない | 不良との関係がない方向 |
| OR>1 | Xが増えるほどオッズが高くなる | 不良が発生しやすい方向 |
| OR<1 | Xが増えるほどオッズが低くなる | 不良が発生しにくい方向 |
事例:加工温度と製品の不良発生の関係を調べる
加工温度Xと製品の不良発生Yの関係を調べます。良品を0、不良品を1とし、150~200℃で製造した30製品の架空データを使用します。
すべての温度で良品と不良品が混在しているため、低温側がすべて0、高温側がすべて1になる完全分離は発生していません。
| No. | 加工温度X(℃) | 判定Y | 判定 |
|---|---|---|---|
| 1 | 150 | 0 | 良品 |
| 2 | 150 | 0 | 良品 |
| 3 | 150 | 1 | 不良品 |
| 4 | 150 | 0 | 良品 |
| 5 | 150 | 0 | 良品 |
| 6 | 160 | 0 | 良品 |
| 7 | 160 | 1 | 不良品 |
| 8 | 160 | 0 | 良品 |
| 9 | 160 | 0 | 良品 |
| 10 | 160 | 0 | 良品 |
| 11 | 170 | 0 | 良品 |
| 12 | 170 | 1 | 不良品 |
| 13 | 170 | 0 | 良品 |
| 14 | 170 | 1 | 不良品 |
| 15 | 170 | 0 | 良品 |
| 16 | 180 | 1 | 不良品 |
| 17 | 180 | 0 | 良品 |
| 18 | 180 | 1 | 不良品 |
| 19 | 180 | 1 | 不良品 |
| 20 | 180 | 0 | 良品 |
| 21 | 190 | 1 | 不良品 |
| 22 | 190 | 1 | 不良品 |
| 23 | 190 | 0 | 良品 |
| 24 | 190 | 1 | 不良品 |
| 25 | 190 | 1 | 不良品 |
| 26 | 200 | 1 | 不良品 |
| 27 | 200 | 0 | 良品 |
| 28 | 200 | 1 | 不良品 |
| 29 | 200 | 1 | 不良品 |
| 30 | 200 | 1 | 不良品 |
① 0/1データを確認する
各温度は5製品ずつです。実測不良率は150℃と160℃で20%、170℃で40%、180℃で60%、190℃と200℃で80%となり、温度とともに上昇する傾向があります。
② ロジスティック回帰モデルを作る
pを不良確率、Xを加工温度として、対数オッズを加工温度の線形式で表します。
③ 最尤法で回帰係数を求める
線形回帰のβ1=Sxy/Sxxのような簡単な式ではなく、ロジスティック回帰の係数は通常、最尤法(Maximum Likelihood Estimation:MLE)で推定します。
各データについて、実際に観測された0または1が得られる確率を最も大きくするβ0とβ1を反復計算で探します。尤度と対数尤度は次のように表せます。
※上記を手計算で実施することは非常に大変なので、実務では統計解析ソフトを使用します。
本記事末尾にブラウザ上で使用できる無料統計ソフトがありますので、そちらを活用してください
ℓ = Σ{yiln(pi) + (1−yi)ln(1−pi)}
この記事では、通常の最尤推定を使用しました。反復計算は収束し、切片β0=−11.7888、加工温度の係数β1=0.06736となりました。
④ 回帰式を完成させる
p = 1 ÷ {1 + exp[−(−11.7888 + 0.06736X)]}
加工温度の係数が正なので、温度が高いほど不良発生の対数オッズが大きくなるモデルです。次に、この式を確率とオッズ比へ変換します。
⑤ 実際に不良確率を計算する
加工温度160℃、180℃、200℃を代入し、線形予測子から不良確率を求めます。
p = 1 ÷ {1 + exp(1.0105)} = 0.2669
180℃:η = −11.7888 + 0.06736 × 180 = 0.3368
p = 1 ÷ {1 + exp(−0.3368)} = 0.5834
200℃:η = −11.7888 + 0.06736 × 200 = 1.6841
p = 1 ÷ {1 + exp(−1.6841)} = 0.8434
| 加工温度 | 線形予測子η | 予測不良確率 |
|---|---|---|
| 160℃ | −1.0105 | 26.69% |
| 180℃ | 0.3368 | 58.34% |
| 200℃ | 1.6841 | 84.34% |
⑥ オッズ比を求める
1℃上昇時のオッズ比はexp(β1)、10℃上昇時はexp(10β1)で求めます。
OR10℃ = exp(10 × 0.06736) = 1.9614
加工温度が1℃上昇すると不良発生オッズは約1.07倍、10℃上昇すると約1.96倍になると解釈します。これは不良確率が10℃ごとに1.96倍になるという意味ではありません。
⑦ 回帰係数のp値と95%信頼区間を確認する
加工温度の係数について、H0:β1=0、H1:β1≠0をWald検定で評価します。z値は係数を標準誤差で割って求めます。
= 0.06736 ÷ 0.02746
= 2.4533
p = 0.01416
係数の95%信頼区間を求め、その上下限をexp変換するとオッズ比の95%信頼区間になります。
= 0.01354 ~ 0.12118
OR1℃の95%CI = exp(0.01354) ~ exp(0.12118)
= 1.0136 ~ 1.1288
OR10℃の95%CI = 1.1451 ~ 3.3597
加工温度のp値は0.05未満で、オッズ比の95%信頼区間も1を含みません。今回のデータでは、加工温度と不良発生に統計的な関係があると判断します。
ロジスティック回帰分析の結果を解釈する
| 項 | 係数 | 標準誤差 | z値 | p値 | オッズ比 | オッズ比95%CI |
|---|---|---|---|---|---|---|
| 切片 | −11.7888 | 4.8235 | −2.4440 | 0.01452 | - | - |
| 加工温度 | 0.06736 | 0.02746 | 2.4533 | 0.01416 | 1.0697 | 1.0136~1.1288 |
加工温度の係数は正でp<0.05です。1℃上昇時のオッズ比は1.0697、10℃上昇時では1.9614なので、温度が高くなるほど不良発生オッズが上昇する傾向があります。
実務ではp値だけで結論を出しません。10℃上昇時のオッズ比と信頼区間、温度ごとの予測不良確率、工程上許容できる変化量を合わせて評価します。
モデル全体の適合度も確認する
ロジスティック回帰には線形回帰のR²と同じ決定係数はありません。係数のp値に加え、尤度比検定、逸脱度、AIC、擬似R²などでモデル全体を確認します。
| 指標 | 結果 | 見方 |
|---|---|---|
| 尤度比χ² | 7.7246 | 切片のみのモデルとの比較 |
| 尤度比検定p値 | 0.00545 | 温度を含むモデル全体は有意 |
| 逸脱度 | 33.8642 | 小さいほど適合が良い方向 |
| AIC | 37.8642 | 候補モデル間の比較に使う |
| McFadden擬似R² | 0.1857 | 線形回帰のR²と同じ基準で読まない |
要因効果プロットから不良確率を確認する
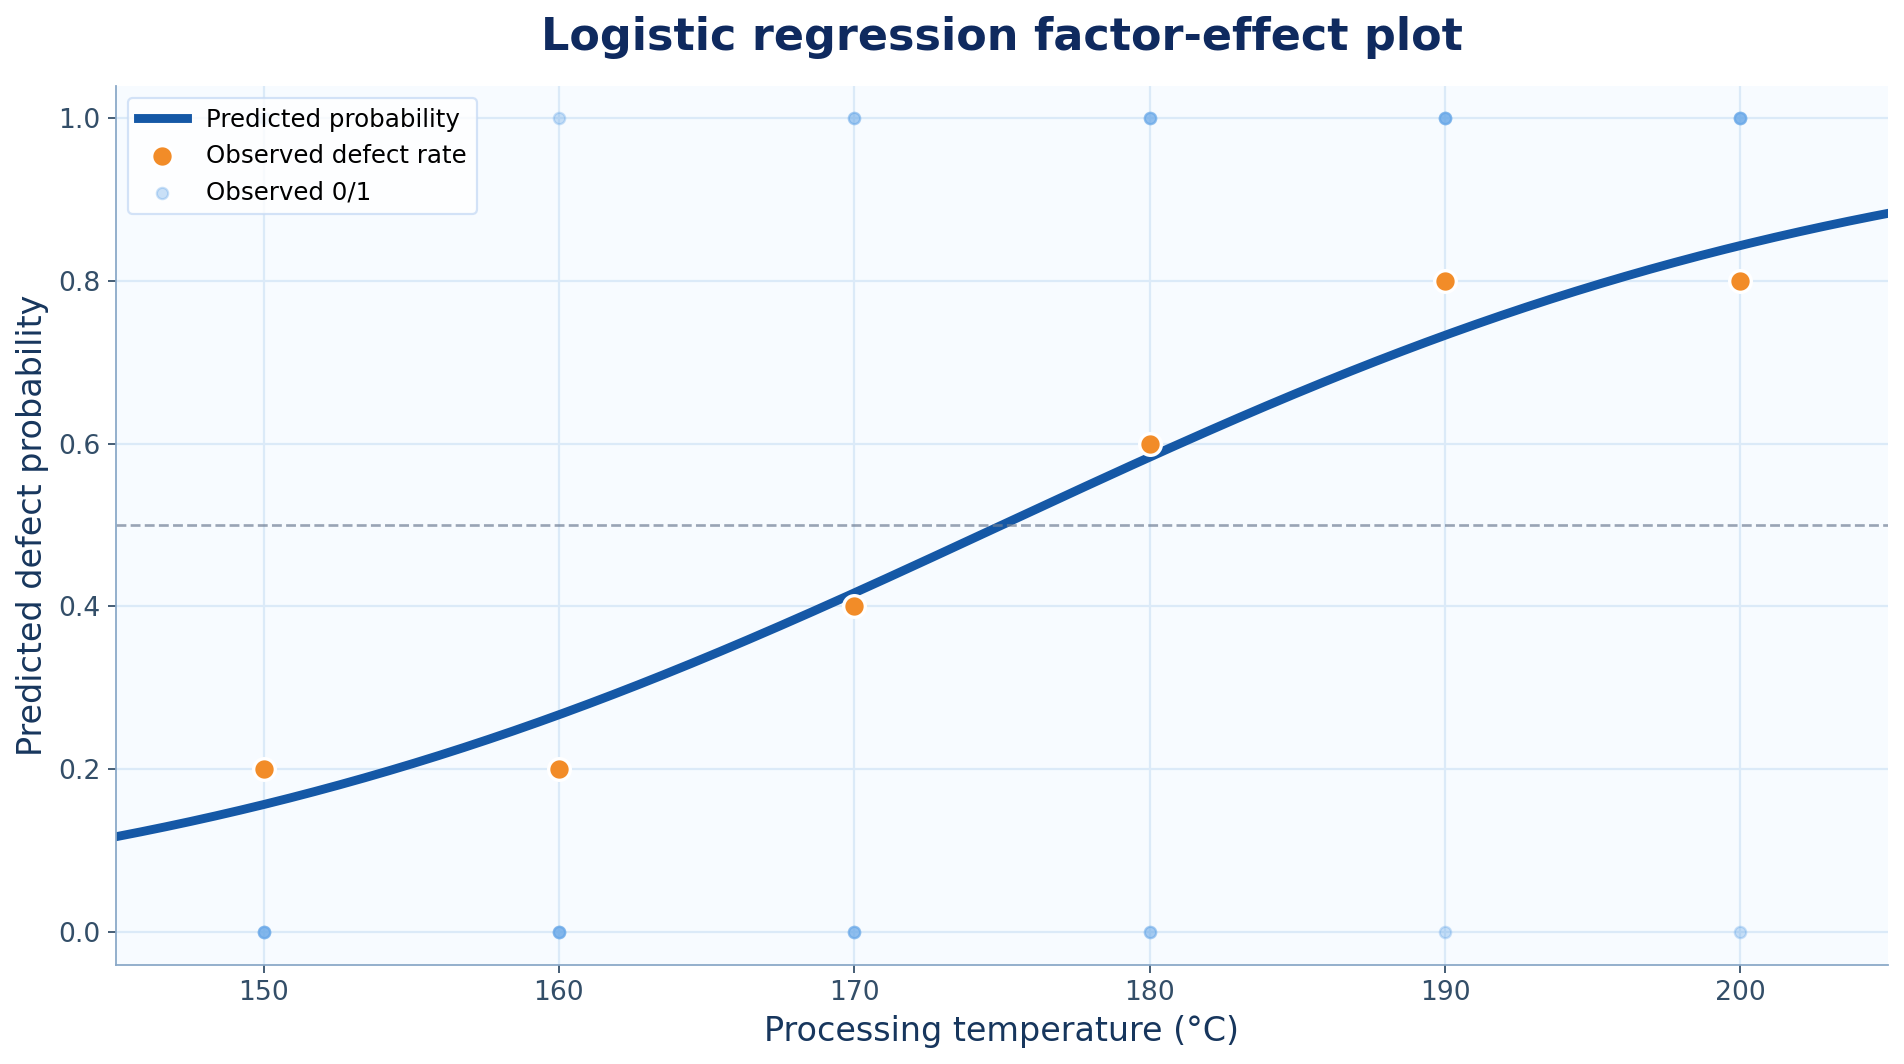
横軸は加工温度、縦軸はモデルから求めた予測不良確率です。加工温度が高くなるにつれて、シグモイド曲線は右上がりとなり、予測不良確率が上昇しています。
低温域と高温域では確率変化が比較的小さく、中央付近では温度上昇に伴って確率が大きく変化します。さらに高温になると、予測確率は1へ近づきます。
係数β1>0 → オッズ比>1 → 温度とともに不良発生オッズが上昇 → シグモイド曲線が右上がり → 予測不良確率が上昇という流れです。係数、オッズ比、確率、要因効果プロットは、同じモデルを異なる形で表しています。
複数の説明変数がある場合
実務では、加工温度に加えて加工時間、圧力、材料特性などを同時にモデルへ入れられます。この場合は、他の説明変数を一定としたときの各因子の影響を評価します。
例えば加工時間を一定としたとき、加工温度が不良発生オッズに与える影響を確認できます。複数変数を扱うときは、説明変数同士の強い相関にも注意します。
StatLAでロジスティック回帰分析を実行する
実際のデータを分析するときは、公開中のStat Lab Analyticsでロジスティック回帰分析を実施する方法を参考にしてください。ブラウザ上で係数、オッズ比、p値、95%信頼区間、予測確率、ROC/AUCを確認できます。
無料統計解析ソフト Stat Lab Analytics(StatLA)
ロジスティック回帰分析を試すp値の基本的な考え方は、p値とは?の記事も参考にしてください。
ロジスティック回帰分析を使うときの注意点
■0と1の定義を確認する
どちらをイベントとして1に設定するかで、係数、オッズ比、グラフの解釈方向が変わります。不良=1なら、正の係数は不良確率が上昇する方向です。
■説明変数とロジットの関係
連続説明変数と確率そのものの直線関係を仮定するわけではありません。連続説明変数とロジットの関係が、おおむね線形であることを仮定します。
■完全分離
あるXの範囲ではすべて0、別の範囲ではすべて1となるデータでは、通常の最尤推定が不安定または成立しないことがあります。データの分布と収束メッセージを確認します。
■サンプルサイズとイベント数
不良件数が極端に少ないと、係数やオッズ比の推定が不安定になります。全体件数だけでなく、イベント数と非イベント数の両方を確認します。
■多重共線性
複数の説明変数を使用する場合は、説明変数同士の強い相関に注意します。係数の符号や標準誤差、VIFなどを確認します。
■外挿
観測したXの範囲を大きく超える確率予測は避けます。シグモイド曲線が0や1へ近づいていても、未観測領域で同じ関係が続くとは限りません。
まとめ
ロジスティック回帰分析は、良品/不良品のような0/1の二値データを目的変数とし、説明変数からイベント発生確率を推定する方法です。確率をオッズ、ロジットへ変換し、最尤法で回帰係数を推定します。
今回の事例では、加工温度の係数は0.06736、p値は0.01416、10℃上昇時のオッズ比は1.9614でした。要因効果プロットも右上がりとなり、加工温度が高いほど予測不良確率が上昇する関係を確認できました。
結果は、係数の符号、p値、オッズ比と95%信頼区間、予測確率、要因効果プロットを組み合わせて解釈することが重要です。工程条件の判断では、統計的有意性だけでなく実務上の影響の大きさも確認しましょう。
Stat Lab Analytics(StatLA)
不良の発生確率を、 実際のデータから 分析してみよう。
良品・不良品などの2値データを入力するだけで解析。
オッズ比やp値、予測不良確率を確認できます。
- 登録不要
- 無料
- ブラウザで利用可能
「研究・品質改善で統計解析方法に迷っている」
製造業・医療機器分野で統計解析を実践してきた専門家が、
目的に合わせた解析方法の選定から結果解釈までサポートします。